Comparativo · · 7 min de leitura
Qual nível de esforço escolher no Claude Fable 5.2? Custo, tempo e tokens nos nossos 41 testes
Um briefing, cinco níveis de esforço: de US$ 1,35 e cerca de 5 minutos no low a US$ 9,09 e mais de 37 minutos no max. Com base nos nossos 41 testes, mostramos o custo, o tempo e os tokens de cada nível no Claude Fable 5.2 e comparamos o novo modelo com o Fable 5.1.
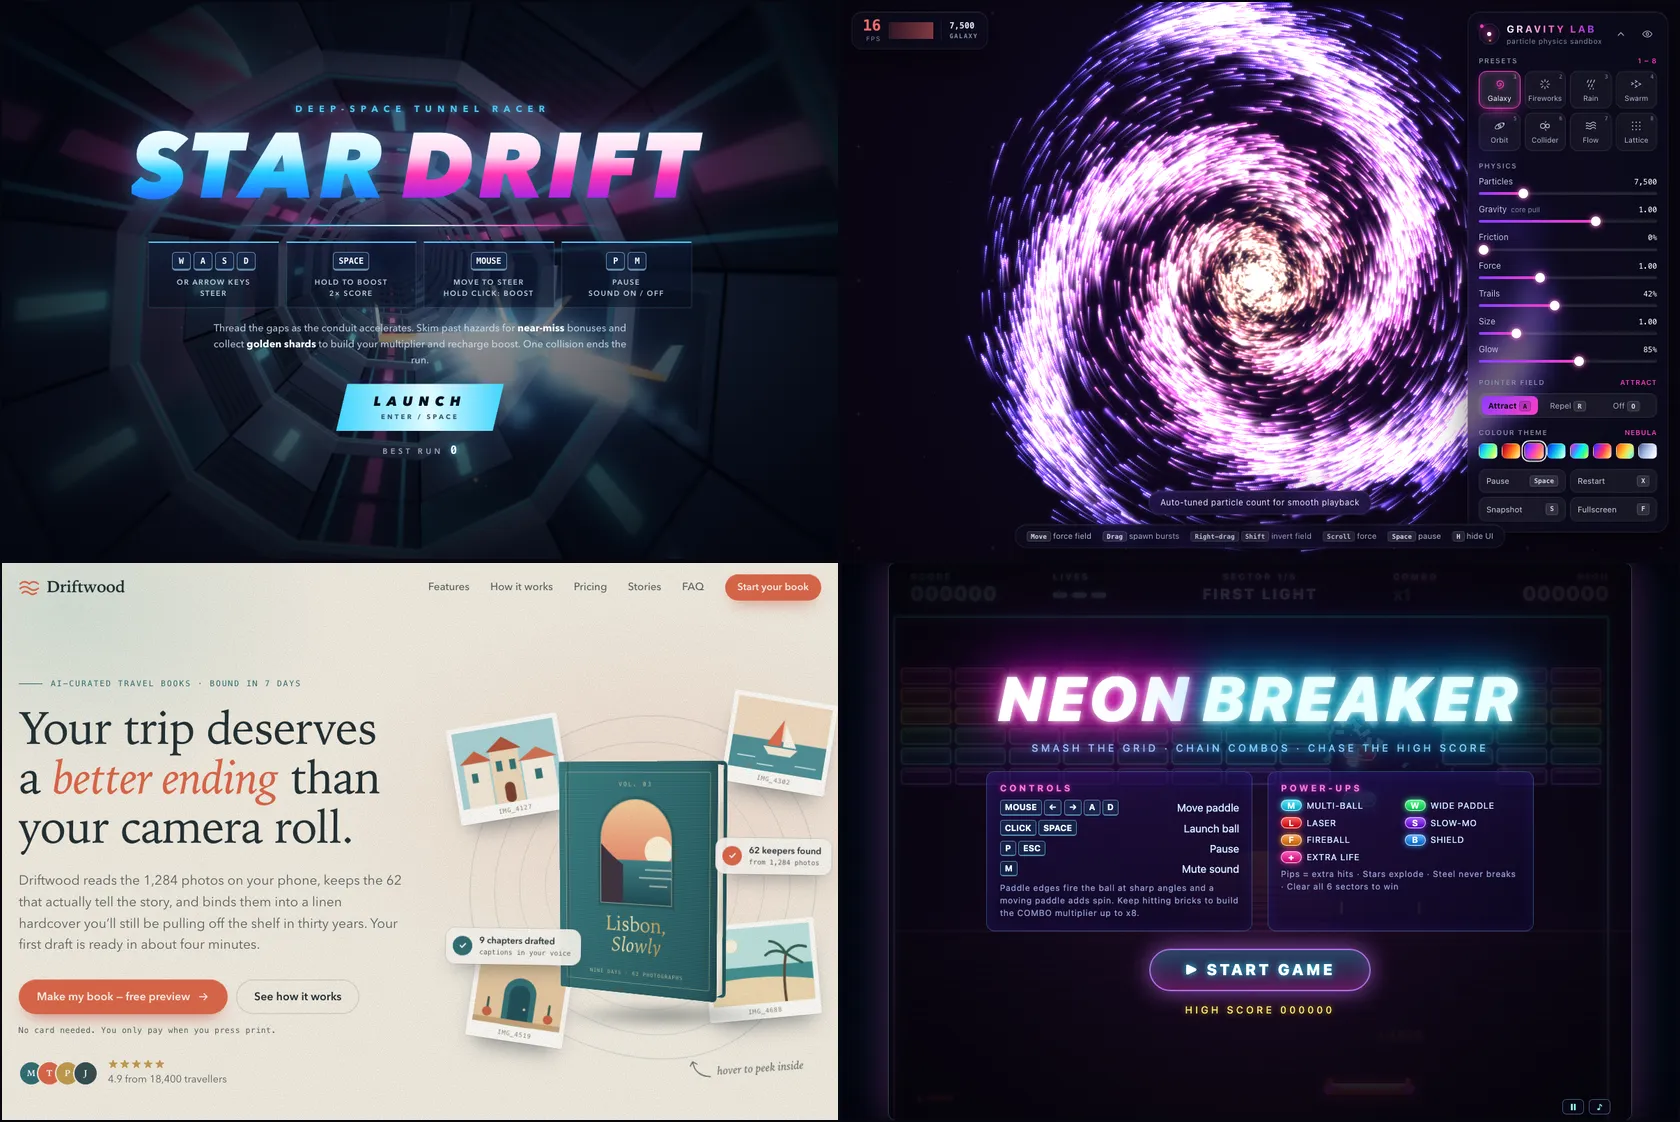
Resumindo: no Claude Fable 5.2, o nível de esforço (effort) muda bastante o custo e o tempo de resposta. No low, a mesma landing page custou US$ 1,35 e ficou pronta em 5 min 4 s; no max, US$ 9,09 e 37 min 34 s. Nesse briefing, o Fable 5.2 escreveu mais tokens que o Fable 5.1 em todos os níveis, e no high, cerca de 4 vezes mais. Se você trabalha com o Fable, comece pelo medium, o nível padrão no Claude Code, e aumente o esforço de forma consciente: nos mesmos briefings, o max custou de 3 a 10 vezes mais que o low.
Você pode abrir todos os resultados lado a lado, cada um com custo, tempo e número de tokens, em testingmodels.com/fable-5-2.
Como medimos
O site testingmodels.com é mantido por Patryk Raba, o mesmo responsável pelo vibecoding.inc, então os testes são nossos. Lá, o Fable 5.2 encarou 21 desafios, de uma landing page e um jogo, passando por um emulador de CHIP-8 e uma simulação de fluidos, até xadrez. Rodamos alguns deles em vários níveis de esforço, por isso são 41 resultados.
- Uma execução por tarefa e nível (n=1). Rodamos cada desafio uma única vez em cada nível pelo CLI do Claude Code, com a flag --effort definida separadamente para cada execução, sem acesso a ferramentas e sem escolher as melhores tentativas.
- Os mesmos briefings para todos os modelos. O Fable 5.2 recebeu exatamente os mesmos prompts que todos os modelos testados no testingmodels.com.
- Custo pela tabela de preços da API. É o valor da execução calculado a US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída, conforme informado pelo CLI. Os testes em si rodaram em uma assinatura, então os dólares são um valor equivalente, não uma cobrança.
- Tempo e tokens. O tempo é o tempo real decorrido da geração. Os tokens são tokens de saída, incluindo os tokens de raciocínio (thinking).
- Sem correções. Publicamos cada resultado exatamente como o modelo o escreveu.
No total, foram US$ 198,48 pela tabela de preços da API, 4.736.435 tokens de saída e 12,7 horas de geração. A descrição completa do método está na metodologia do Testing Models.
Resultados: custo, tempo e tokens em cada nível
Um briefing, cinco níveis de esforço
A comparação mais completa vem do briefing Driftwood, a landing page de um SaaS fictício para criar fotolivros de viagem. O ambiente e o prompt são os mesmos, e só muda o nível de esforço:
- low: US$ 1,35, 5 min 4 s, 33,6 mil tokens
- medium: US$ 2,08, 7 min 58 s, 51,5 mil tokens
- high: US$ 4,72, 18 min 38 s, 117,7 mil tokens
- xhigh: US$ 9,07, 27 min 46 s, 175,2 mil tokens
- max: US$ 9,09, 37 min 34 s, 226,5 mil tokens
No topo da escala, xhigh e max custaram quase o mesmo, mas a execução no max levou 37 min 34 s em vez de 27 min 46 s e gerou 226,5 mil tokens em vez de 175,2 mil. O valor informado pelo CLI também inclui o custo do lado da entrada, então não precisa crescer na mesma proporção que os tokens de saída.
As médias dos 41 resultados seguem um padrão parecido (low: US$ 1,87; high: US$ 5,20; max: US$ 9,73), mas cada uma abrange um conjunto diferente de tarefas, então é melhor comparar o mesmo briefing.
No mesmo briefing, o max custou de 3,1 a 10,3 vezes mais que o low: landing page 6,7 vezes, jogo 4,6, ferramenta 7,6, dashboard 5,2, partículas 5,9, emulador de CHIP-8 10,3, site de notícias 4,0, digger 3,1. O tempo cresceu mais ou menos no mesmo ritmo, de 3,2 a 11,8 vezes.
Fable 5.2 vs Fable 5.1 no mesmo briefing
Também temos o briefing Driftwood rodado no Fable 5.1, nível por nível. O novo modelo escreveu mais tokens em todos os níveis e terminou mais tarde em todos eles:
- low: 33,6 mil contra 27,4 mil tokens (+23%), 5 min 4 s contra 4 min 53 s
- medium: 51,5 mil contra 26,5 mil (+94%), 7 min 58 s contra 4 min 55 s
- high: 117,7 mil contra 29,7 mil (+297%), 18 min 38 s contra 5 min 26 s
- xhigh: 175,2 mil contra 95,7 mil (+83%), 27 min 46 s contra 18 min
- max: 226,5 mil contra 144,3 mil (+57%), 37 min 34 s contra 30 min 16 s
A maior diferença apareceu no high: cerca de 4 vezes mais tokens e 3,4 vezes mais tempo. Em outros briefings em que os dois modelos têm resultado no mesmo nível, o Fable 5.2 também sempre escreveu mais: no low, de 1,3 a 2,4 vezes mais tokens que o Fable 5.1; no high, de 1,5 a 2,3 vezes; e no max, a diferença foi a menor (jogo: 216,0 mil contra 198,8 mil; dashboard: 216,3 mil contra 197,6 mil).
Em dólares, o quadro é outro e fácil de interpretar mal. No low, o Fable 5.2 saiu mais barato (US$ 1,35 contra US$ 2,17), embora tenha escrito mais tokens. O novo modelo tem preços 20% menores: US$ 8 e US$ 40 por milhão de tokens de entrada e de saída, contra US$ 10 e US$ 50 no Fable 5.1.
Além disso, os custos do Fable 5.1 informados pelo CLI incluem cerca de US$ 1,21 do lado da entrada por execução, contra US$ 0,42 no Fable 5.2. Na comparação entre os modelos, portanto, o que mais conta são os tokens. Falamos da nova tabela de preços e das demais mudanças no nosso artigo sobre o lançamento do Fable 5.2.
O Fable 5.2 também gera tokens mais rápido. Pelo nosso cálculo (tokens de saída divididos pelo tempo real decorrido no briefing Driftwood), o novo modelo produz cerca de 100 a 110 tokens por segundo, e o Fable 5.1, cerca de 80 a 94, ou seja, o Fable 5.2 é de 16% a 26% mais rápido. Isso bate com a afirmação da Anthropic de que os modelos 5.2 geram respostas até 30% mais rápido que as versões 5.1. O tempo real inclui overhead, então trate isso como uma aproximação.
Tokens mais rápidos, porém, não significam uma resposta mais rápida: no mesmo nível, o Fable 5.2 terminava mais tarde porque escrevia mais. Vamos comparar isso com o que a Anthropic diz no anúncio do lançamento (tradução nossa):
No esforço Medium (o padrão nos apps do Claude e no Claude Code), o Fable 5.2 consegue realizar tarefas desafiadoras com menos tokens que o Fable 5.1.
No nosso briefing, em uma única execução, o Fable 5.2 no medium escreveu 51,5 mil tokens, e o Fable 5.1, 26,5 mil, ou seja, 94% a mais. É uma observação, não uma refutação da afirmação da Anthropic: um briefing e uma execução são pouco, e uma landing page não é necessariamente o que a empresa chama de tarefa desafiadora. Ainda assim, se você migrar trabalho do 5.1 para o 5.2 sem mudar o nível, confira o consumo de tokens nas suas próprias tarefas em vez de supor que ele vai cair.
O que isso significa para o seu trabalho
- Medium como ponto de partida. É o nível padrão nos apps do Claude e no Claude Code (segundo a Anthropic). No briefing Driftwood, custou US$ 2,08 e levou 7 min 58 s, enquanto o high já chegou a US$ 4,72 e 18 min 38 s.
- Do high para cima, é uma decisão de orçamento. Nos mesmos briefings, o max custou de 3 a 10 vezes mais que o low, e o tempo cresceu de forma parecida. Suba o nível quando o resultado de um nível mais baixo não for suficiente, e não por hábito.
- Na assinatura, você paga com o limite de uso. Os dólares deste texto não vão parar na sua fatura, mas os tokens e o tempo continuam os mesmos. A Anthropic informa que, durante a semana de lançamento, os assinantes de planos pagos elegíveis recebem de uma a três redefinições do limite do Fable, conforme o tempo de assinatura, e que o Fable pode representar até 50% do limite de uso semanal no plano Pro e nos assentos padrão do plano Team. Nos nossos testes, o Driftwood no max deu 226,5 mil tokens de saída, e no medium, 51,5 mil, então conte com o fato de que, nos níveis altos, você vai se aproximar do limite mais rápido.
- A Anthropic recomenda começar pelo Opus 5.5. Para a maioria das tarefas de programação e de conhecimento, a empresa recomenda começar pelo Claude Opus 5.5, que ela chama de seu modelo mais forte para o dia a dia, e trocar de modelo quando necessário, conforme o escopo e a complexidade do trabalho. Nossos números se referem apenas ao Fable, então não verificamos essa recomendação.
O que esses dados não dizem
- Uma única execução. Cada número vem de uma única execução (n=1), então repetir o mesmo briefing pode dar outro custo e outro tempo.
- Sem avaliação de qualidade. A página mostra custo, tempo e tokens. Ela não diz qual nível fez a melhor landing page, e não afirmamos que um esforço maior dê um resultado melhor.
- Nem tudo funciona. O emulador de CHIP-8 no low e no max dá erro ao carregar, porque o modelo escreveu dados de ROM incorretos em base64. Publicamos os dois resultados como foram gerados, sem correções.
- Uma execução repetida. Um limite de uso interrompeu a primeira tentativa do jogo 3D no high antes que qualquer resultado fosse gerado, então rodamos de novo. A página marca esse resultado como gerado pela segunda vez.
A avaliação da qualidade fica com você. Em testingmodels.com/fable-5-2, você encontra os 41 resultados do Fable 5.2 e pode abrir low, medium, high e max lado a lado, exatamente como o modelo os escreveu. Antes de fixar o nível de esforço de vez, veja o que você ganha a cada degrau acima.
Fontes: Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2, testingmodels.com/fable-5-2, testingmodels.com/method.