Comparativa · · 7 min de lectura
¿Qué nivel de esfuerzo elegir en Claude Fable 5.2? Costo, tiempo y tokens en nuestras 41 pruebas
Un brief, cinco niveles de esfuerzo: de 1,35 dólares y unos 5 minutos en low a 9,09 dólares y más de 37 minutos en max. A partir de nuestras 41 pruebas, mostramos el costo, el tiempo y los tokens de cada nivel en Claude Fable 5.2 y comparamos el nuevo modelo con Fable 5.1.
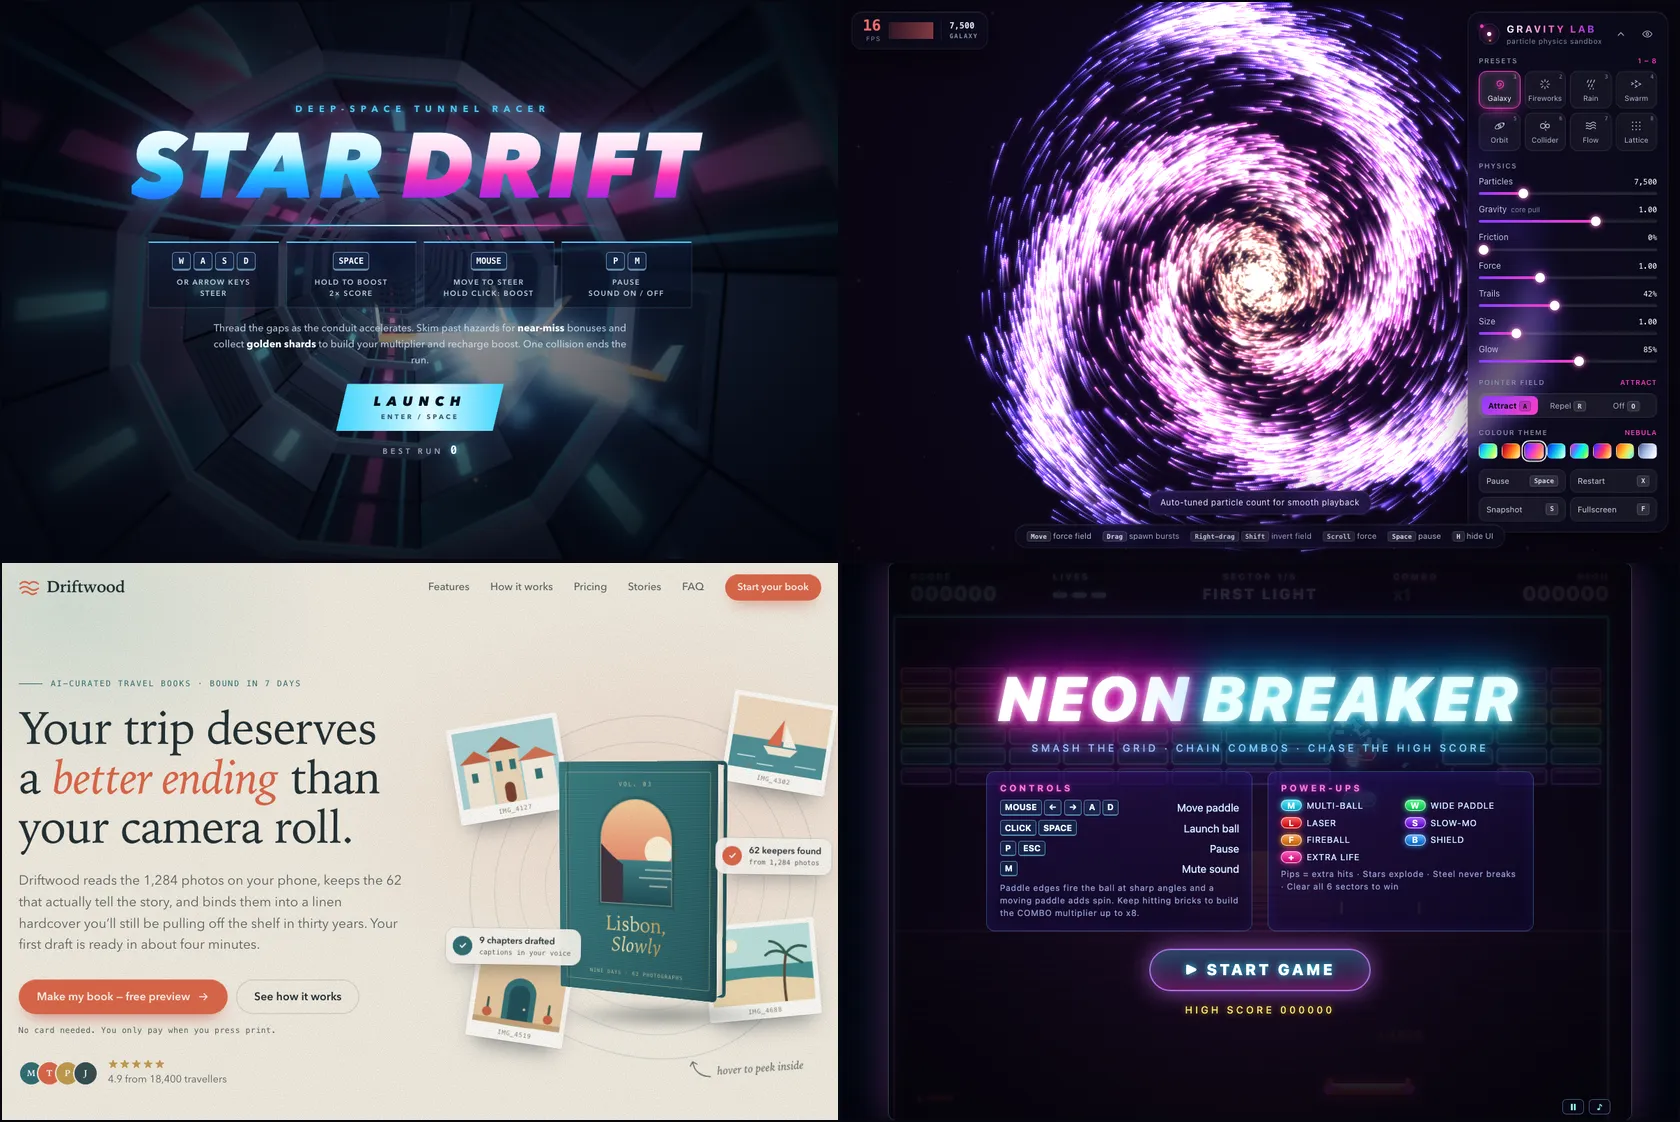
En resumen: en Claude Fable 5.2, el nivel de esfuerzo (effort) cambia mucho el costo y el tiempo de respuesta. En low, la misma landing page costó 1,35 dólares y estuvo lista en 5 min 4 s; en max, 9,09 dólares y 37 min 34 s. En este brief, Fable 5.2 escribió más tokens que Fable 5.1 en todos los niveles, y en high, unas 4 veces más. Si trabajas con Fable, empieza por medium, el nivel predeterminado en Claude Code, y sube el esfuerzo de forma consciente: en los mismos briefs, max costó entre 3 y 10 veces más que low.
Puedes abrir todos los resultados uno al lado del otro, cada uno con su costo, su tiempo y su número de tokens, en testingmodels.com/fable-5-2.
Cómo lo medimos
El sitio testingmodels.com lo dirige Patryk Raba, el mismo editor de vibecoding.inc, así que son nuestras propias pruebas. Allí, Fable 5.2 se enfrentó a 21 retos, desde una landing page y un juego, pasando por un emulador de CHIP-8 y una simulación de fluidos, hasta el ajedrez. Algunos los ejecutamos en varios niveles de esfuerzo, de ahí los 41 resultados.
- Una ejecución por tarea y nivel (n=1). Ejecutamos cada reto una sola vez en cada nivel a través de la CLI de Claude Code, con la opción --effort ajustada por separado en cada ejecución, sin acceso a herramientas y sin elegir los mejores intentos.
- Los mismos briefs para todos los modelos. Fable 5.2 recibió exactamente los mismos prompts que todos los modelos probados en testingmodels.com.
- Costo según la tarifa de la API. Es el precio de la ejecución a 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida, tal como lo indica la CLI. Las pruebas en sí se hicieron con una suscripción, así que los dólares son un equivalente, no una factura.
- Tiempo y tokens. El tiempo es el tiempo real transcurrido durante la generación. Los tokens son tokens de salida, incluidos los tokens de pensamiento (thinking).
- Sin correcciones. Publicamos cada resultado exactamente como lo escribió el modelo.
En total fueron 198,48 dólares según la tarifa de la API, 4 736 435 tokens de salida y 12,7 horas de generación. Encontrarás la descripción completa del método en la metodología de Testing Models.
Resultados: costo, tiempo y tokens en cada nivel
Un brief, cinco niveles de esfuerzo
La comparación más completa la ofrece el brief Driftwood, la landing page de un SaaS ficticio para crear fotolibros de viaje. El entorno y el prompt son los mismos, y solo cambia el nivel de esfuerzo:
- low: 1,35 dólares, 5 min 4 s, 33,6 mil tokens
- medium: 2,08 dólares, 7 min 58 s, 51,5 mil tokens
- high: 4,72 dólares, 18 min 38 s, 117,7 mil tokens
- xhigh: 9,07 dólares, 27 min 46 s, 175,2 mil tokens
- max: 9,09 dólares, 37 min 34 s, 226,5 mil tokens
En lo más alto de la escala, xhigh y max costaron casi lo mismo, pero la ejecución en max duró 37 min 34 s en lugar de 27 min 46 s y generó 226,5 mil tokens en lugar de 175,2 mil. El importe que indica la CLI también incluye el costo del lado de la entrada, así que no tiene por qué crecer al mismo ritmo que los tokens de salida.
Los promedios de los 41 resultados siguen un patrón parecido (low 1,87 dólares, high 5,20 dólares, max 9,73 dólares), pero cada uno abarca un conjunto distinto de tareas, así que es mejor comparar el mismo brief.
En el mismo brief, max costó entre 3,1 y 10,3 veces más que low: landing page 6,7 veces, juego 4,6, herramienta 7,6, dashboard 5,2, partículas 5,9, emulador de CHIP-8 10,3, sitio de noticias 4,0, digger 3,1. El tiempo creció más o menos al mismo ritmo, entre 3,2 y 11,8 veces.
Fable 5.2 frente a Fable 5.1 en el mismo brief
También tenemos el brief Driftwood ejecutado con Fable 5.1, nivel por nivel. El nuevo modelo escribió más tokens en todos los niveles y en todos terminó más tarde:
- low: 33,6 mil frente a 27,4 mil tokens (+23%), 5 min 4 s frente a 4 min 53 s
- medium: 51,5 mil frente a 26,5 mil (+94%), 7 min 58 s frente a 4 min 55 s
- high: 117,7 mil frente a 29,7 mil (+297%), 18 min 38 s frente a 5 min 26 s
- xhigh: 175,2 mil frente a 95,7 mil (+83%), 27 min 46 s frente a 18 min
- max: 226,5 mil frente a 144,3 mil (+57%), 37 min 34 s frente a 30 min 16 s
La mayor diferencia se dio en high: unas 4 veces más tokens y 3,4 veces más tiempo. En otros briefs en los que ambos modelos tienen resultado en el mismo nivel, Fable 5.2 también escribió siempre más: en low, entre 1,3 y 2,4 veces más tokens que Fable 5.1; en high, entre 1,5 y 2,3 veces, y en max, la diferencia fue la menor (juego: 216,0 mil frente a 198,8 mil; dashboard: 216,3 mil frente a 197,6 mil).
En dólares el panorama es distinto y fácil de malinterpretar. En low, Fable 5.2 salió más barato (1,35 frente a 2,17 dólares), aunque escribió más tokens. El nuevo modelo tiene tarifas un 20% más bajas: 8 y 40 dólares por millón de tokens de entrada y de salida, frente a 10 y 50 dólares en Fable 5.1.
Además, los costos de Fable 5.1 que indica la CLI incluyen unos 1,21 dólares del lado de la entrada por ejecución, frente a 0,42 dólares en Fable 5.2. Por eso, al comparar los modelos, lo que más cuenta son los tokens. Explicamos los nuevos precios y el resto de los cambios en nuestro artículo sobre el lanzamiento de Fable 5.2.
Fable 5.2 también genera tokens más rápido. Según nuestro cálculo (tokens de salida divididos entre el tiempo real transcurrido en el brief Driftwood), el nuevo modelo produce alrededor de 100 a 110 tokens por segundo, y Fable 5.1, alrededor de 80 a 94; es decir, Fable 5.2 es entre un 16% y un 26% más rápido. Esto coincide con la afirmación de Anthropic de que los modelos 5.2 generan respuestas hasta un 30% más rápido que las versiones 5.1. El tiempo real incluye cierta sobrecarga, así que tómalo como una aproximación.
Sin embargo, generar tokens más rápido no significa responder antes: en el mismo nivel, Fable 5.2 terminaba más tarde porque escribía más. Comparemos esto con lo que dice Anthropic en el anuncio del lanzamiento (traducción nuestra):
Con el esfuerzo Medium (el predeterminado en las aplicaciones de Claude y en Claude Code), Fable 5.2 puede llevar a cabo tareas exigentes con menos tokens que Fable 5.1.
En nuestro brief, en una sola ejecución, Fable 5.2 en medium escribió 51,5 mil tokens, y Fable 5.1, 26,5 mil, es decir, un 94% más. Es una observación, no una refutación de lo que afirma Anthropic: un brief y una ejecución no bastan, y una landing page no tiene por qué ser lo que la empresa considera una tarea exigente. Aun así, si pasas trabajo de 5.1 a 5.2 sin cambiar el nivel, revisa el consumo de tokens en tus propias tareas en lugar de dar por hecho que bajará.
Qué significa esto para tu trabajo
- Medium como punto de partida. Es el nivel predeterminado en las aplicaciones de Claude y en Claude Code (según Anthropic). En el brief Driftwood costó 2,08 dólares y tardó 7 min 58 s, mientras que high ya llegó a 4,72 dólares y 18 min 38 s.
- De high para arriba, es una decisión de presupuesto. En los mismos briefs, max costó entre 3 y 10 veces más que low, y el tiempo creció de forma parecida. Sube el nivel cuando el resultado de uno más bajo no te baste, no por costumbre.
- Con suscripción, pagas con tu límite de uso. Los dólares de este artículo no llegarán a tu factura, pero los tokens y el tiempo son los mismos. Anthropic indica que, durante la semana del lanzamiento, los suscriptores de planes de pago elegibles reciben entre uno y tres reinicios del límite de Fable, según la antigüedad de su suscripción, y que Fable puede representar hasta el 50% del límite de uso semanal en el plan Pro y en los puestos estándar del plan Team. En nuestras pruebas, Driftwood en max supuso 226,5 mil tokens de salida, y en medium, 51,5 mil, así que cuenta con que los niveles altos te acerquen antes al límite.
- Anthropic recomienda empezar con Opus 5.5. Para la mayoría de las tareas de programación y de conocimiento, la empresa recomienda empezar con Claude Opus 5.5, al que llama su modelo más potente para el día a día, y cambiar de modelo cuando haga falta, según el alcance y la complejidad del trabajo. Nuestras cifras solo se refieren a Fable, así que no verificamos este consejo.
Lo que estos datos no dicen
- Una sola ejecución. Cada cifra procede de una única ejecución (n=1), así que repetir el mismo brief puede dar otro costo y otro tiempo.
- Sin evaluación de calidad. La página muestra costo, tiempo y tokens. No dice qué nivel hizo la mejor landing page, y no afirmamos que un esfuerzo mayor dé un mejor resultado.
- No todo funciona. El emulador de CHIP-8 en low y en max da un error al cargar, porque el modelo escribió datos de ROM erróneos en base64. Publicamos ambos resultados tal como se generaron, sin correcciones.
- Una ejecución repetida. Un límite de uso cortó el primer intento del juego 3D en high antes de que se generara ningún resultado, así que lo volvimos a ejecutar. La página marca este resultado como generado por segunda vez.
La evaluación de la calidad te la dejamos a ti. En testingmodels.com/fable-5-2 encontrarás los 41 resultados de Fable 5.2 y podrás abrir low, medium, high y max uno al lado del otro, exactamente como los escribió el modelo. Antes de dejar fijo un nivel de esfuerzo, mira qué obtienes con cada escalón hacia arriba.
Fuentes: Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2, testingmodels.com/fable-5-2, testingmodels.com/method.